¿Qué es un raspador de imágenes? ¿Cómo funciona, usos comunes y es legal?
¿Qué es un raspador de imágenes, cómo funciona y es legal? Una guía en inglés sencillo para extraer imágenes de cualquier sitio web: usos, tipos de herramientas y línea legal.
Un raspador de imágenes es una herramienta que busca y recopila automáticamente todos los archivos de imágenes en una página web, para que no tengas que guardarlos uno por uno. Pegue una URL y extraerá todas las fotos, gráficos e íconos que carga la página y luego le entregará los archivos o sus enlaces.
Si solo necesita capturar imágenes ahora, pruebe nuestro scraper de imágenes.
Esa es la respuesta corta. Pero el "raspador de imágenes" se mezcla con descargadores, extractores y rastreadores todo el tiempo, y la pregunta más importante que la gente realmente quiere responder es si usar uno es legal. Esta guía cubre lo que hace un raspador de imágenes, cómo funciona, para qué lo usa la gente y dónde se encuentra la línea legal.
No se requiere ningún código para seguir adelante, y seré sincero con usted acerca de las áreas legales grises en lugar de agitarlas con la mano.
¿Qué es un raspador de imágenes?
Un raspador de imágenes lee una página web de la misma manera que lo hace su navegador, selecciona cada imagen que contiene y las reúne en un solo lugar. En lugar de hacer clic derecho en cuarenta fotos en una galería, le das al raspador la página y te devuelve las cuarenta a la vez.
La mayoría de los scrapers van más allá de las obvias etiquetas <img>. Uno bueno también atrapa:
Imágenes
srcsetresponsivas, eligiendo la versión de mayor resolución.Imágenes cargadas de forma diferida que solo aparecen a medida que te desplazas.
Imágenes de fondo configuradas en CSS, que no son etiquetas de imagen en absoluto.
Gráficos vectoriales como logotipos e íconos SVG.
El objetivo de la herramienta es la velocidad y la integridad. Un guardado manual omite los archivos ocultos y cargados de forma diferida. Se construye un raspador para encontrarlos.
¿Cómo funciona un raspador de imágenes?
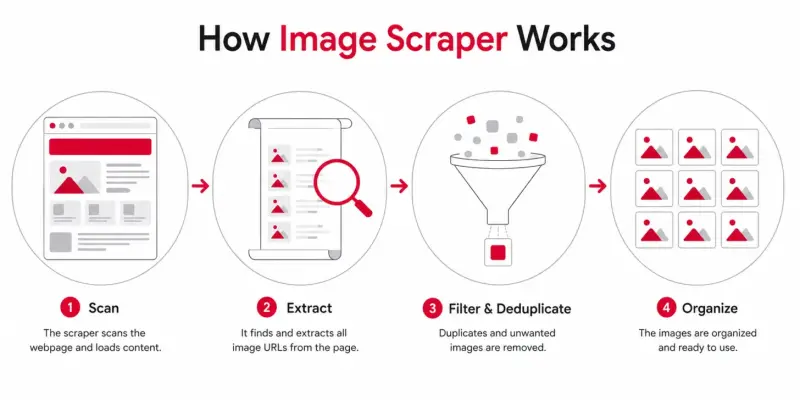
En el fondo, el proceso es bastante simple, incluso si la ingeniería no lo es:
Carga la página. Los mejores raspadores utilizan un motor de navegador real, por lo que JavaScript se ejecuta y las galerías dinámicas realmente se representan.
Se desplaza y espera. Esto activa imágenes cargadas de forma diferida que no existirían en el HTML sin formato.
Lee la página en busca de fuentes de imágenes. Extrae URL de etiquetas
<img>, atributossrcset, marcadores de posicióndata-srcy fondos CSS.Desduplica. La misma imagen suele aparecer en varios tamaños, por lo que el raspador recorta los duplicados.
Devuelve los resultados. Obtiene una lista de URL, miniaturas para elegir o un ZIP de los archivos.
La diferencia entre un raspador débil y uno fuerte se reduce al primer paso. Una herramienta que solo lee HTML sin formato pierde todo lo que un sitio moderno con mucho JavaScript carga después del hecho. Uno que ejecuta un navegador real lo detecta.
Raspador de imágenes, descargador y extractor: ¿cuál es la diferencia?
Estos términos se utilizan como si significaran lo mismo y, en la práctica, en su mayoría así es. Las ligeras distinciones:
Scraper sugiere automatización: lee la página y extrae imágenes mediante programación.
Extractor es la misma idea, que se utiliza a menudo para herramientas basadas en navegador. Un extractor de imágenes y un raspador de imágenes hacen el mismo trabajo.
Downloader se inclina hacia el paso de guardar: colocar los archivos en su dispositivo una vez que los encuentre.
No pienses demasiado en las etiquetas. Si una herramienta encuentra las imágenes en una página y se las proporciona, el nombre en el cuadro no cambia lo que hace.
¿Para qué usa la gente los raspadores de imágenes?
Muchas razones ordinarias y evidentes:
Los diseñadores recopilan imágenes de referencia y material de moodboards de toda la web.
Los desarrolladores extraen recursos durante la migración de un sitio o para pruebas locales, en lugar de buscar en los archivos fuente.
Los comercialistas reúnen creatividades publicitarias de la competencia y fotografías de productos para analizarlas.
Los investigadores crean conjuntos de datos de imágenes para estudios o aprendizaje automático.
Los equipos de SEO auditan las imágenes de un sitio, comprobando el texto alternativo, los tamaños de archivos y los formatos de forma masiva.
El hilo conductor es recopilar imágenes que ya son públicas, para mirarlas o trabajar con ellas, no para hacerlas pasar como propias.
Tipos de raspadores de imágenes
Tienes tres opciones amplias, desde la más fácil hasta la más técnica.
Herramientas web sin código. Pegas una URL en un sitio web y te devuelve las imágenes. No hay nada que instalar, funciona en cualquier dispositivo, maneja las cosas dinámicas y de carga diferida por usted. ExtractPics es uno de estos. Lo mejor para la mayoría de las personas.
Extensiones del navegador. Un botón de la barra de herramientas que escanea la pestaña abierta. Conveniente para las páginas que visita con frecuencia, pero sea exigente: instale sólo las que tengan buenas calificaciones y verifique sus permisos. Una extensión que quiere su historial de navegación completo es una señal de alerta.
Código y scripts. Las bibliotecas de Python como BeautifulSoup o un navegador sin cabeza te brindan control total y te permiten realizar scraping a escala. La contrapartida es que tienes que escribir y mantener el código, manejar los sitios que bloquean los bots y saber lo que estás haciendo. Exagerado si solo quieres las imágenes de una página.
Si prefieres ver recomendaciones específicas, comparamos las las mejores herramientas gratuitas de extracción de imágenes por separado.
¿Es legal el scraping de imágenes?
La respuesta honesta: normalmente sí para las imágenes públicas, con excepciones reales. No soy abogado, así que trate esto como un mapa del terreno, no como asesoramiento legal, y para cualquier asunto comercial o de gran escala, hable con uno.
Aquí está el marco al que se reduce la mayor parte:
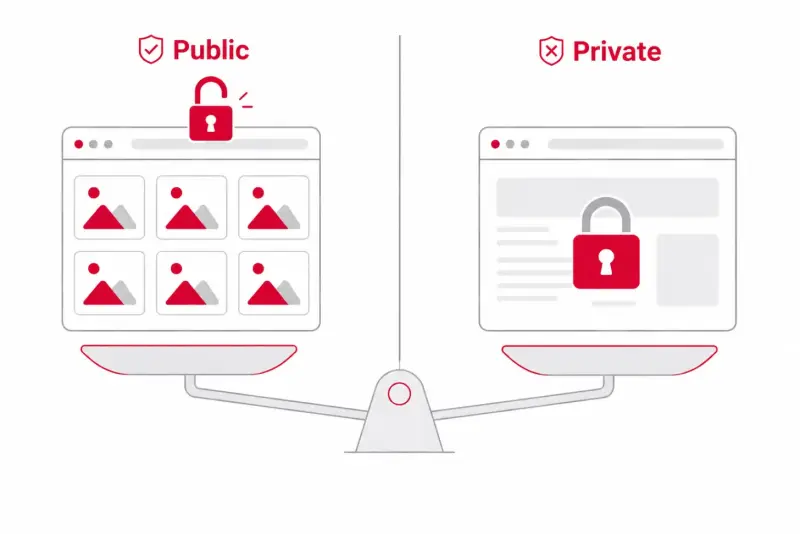
Público versus privado. La extracción de imágenes que cualquier visitante puede ver sin iniciar sesión generalmente es de bajo riesgo. En el momento en que evitas un inicio de sesión, un muro de pago u otro control de acceso, estás en un territorio mucho más riesgoso; ahí es donde entran en juego las leyes de acceso a las computadoras.
Aún se aplican los derechos de autor. Este es el más importante para las imágenes. Una fotografía o ilustración es un trabajo creativo y el hecho de que puedas descargarla no te da derecho a reutilizarla. Recopilar imágenes para referencia o análisis es muy diferente a volver a publicarlas como propias.
Los términos de servicio son importantes. Si los términos de un sitio prohíben el scraping y usted los ha aceptado, ignorarlos puede ser una cuestión contractual, independiente de los derechos de autor.
robots.txt es una señal, no una ley. Indica a las herramientas automatizadas qué áreas el propietario preferiría que usted omita. Ignorarlo no es un delito, pero respetarlo demuestra buena fe, e ignorarlo tiende a bloquear rápidamente su IP.
Los datos personales son una categoría propia. Las imágenes de personas identificables pueden estar sujetas a reglas de privacidad como GDPR o CCPA, incluso cuando se publican públicamente. El raspado de rostros para cosas como el reconocimiento facial ha metido a las empresas en serios problemas.
La regla general más simple: extraer imágenes públicas para mirarlas, estudiarlas o compararlas suele estar bien. Raspar para volver a publicar, revender o perfilar personas es donde deja de estar bien. Los tribunales tienden a preocuparse por por qué recopiló los datos y cómo accedió a ellos, no solo por el acto en sí.
Cómo extraer imágenes sin escribir código
Si todo esto te hace querer capturar algunas imágenes, no necesitas un script. Pegue la URL de la página en ExtractPics, déjelo escanear y descargue lo que necesite; maneja las imágenes de fondo CSS y de carga diferida automáticamente. Para varias páginas a la vez, el Bulk Extractor toma varias URL.
¿Quieres el tutorial completo, incluidos los métodos de desarrollador? Consulta nuestra guía sobre cómo extraer recursos de cualquier sitio web.
Lo que no debe hacer un raspador responsable
Un flujo de trabajo responsable permanece en las páginas públicas, utiliza una tasa de solicitudes modesta y se detiene cuando un sitio indica que el acceso está restringido. No debe anular la autenticación, los CAPTCHA, los muros de pago, los límites de tarifas ni los controles técnicos. También debería preservar la información fuente en lugar de convertir los archivos en una carpeta imposible de rastrear.
El scraping recopila datos; no transfiere derechos de autor ni renuncia a los términos de un sitio. Revise el permiso y el uso previsto por separado.
Guías relacionadas de ExtractPics
- Cómo extraer imágenes de cualquier sitio web (guía paso a paso)
- Cómo descargar varias imágenes a la vez
- Cómo extraer la URL de una imagen de un sitio web
- ¿Es legal descargar imágenes de Internet?
Fuentes y verificación
Este artículo se revisó con la siguiente documentación y estándares principales en agosto de 2026:
- Estándar HTML WHATWG: contenido incrustado
- MDN: el elemento de imagen HTML
- EE.UU. Oficina de derechos de autor: uso legítimo
Utilice el raspado como paso de recopilación
Un raspador de imágenes puede reemplazar cientos de guardados manuales, pero el resultado aún necesita revisión. Elimine los recursos de la interfaz, confirme que los archivos responsivos sean originales genuinos y registre de dónde proviene cada lote. Para una página pública única, utilice una herramienta sin código. Para trabajos recurrentes o de gran tamaño, obtenga permiso y diseñe un proceso de velocidad limitada.