Imágenes PDF incrustadas frente a páginas renderizadas: ¿cuál es la diferencia?
Elija el método de imagen PDF correcto entendiendo qué se almacena dentro del archivo y qué dibuja un visor de PDF en la pantalla.
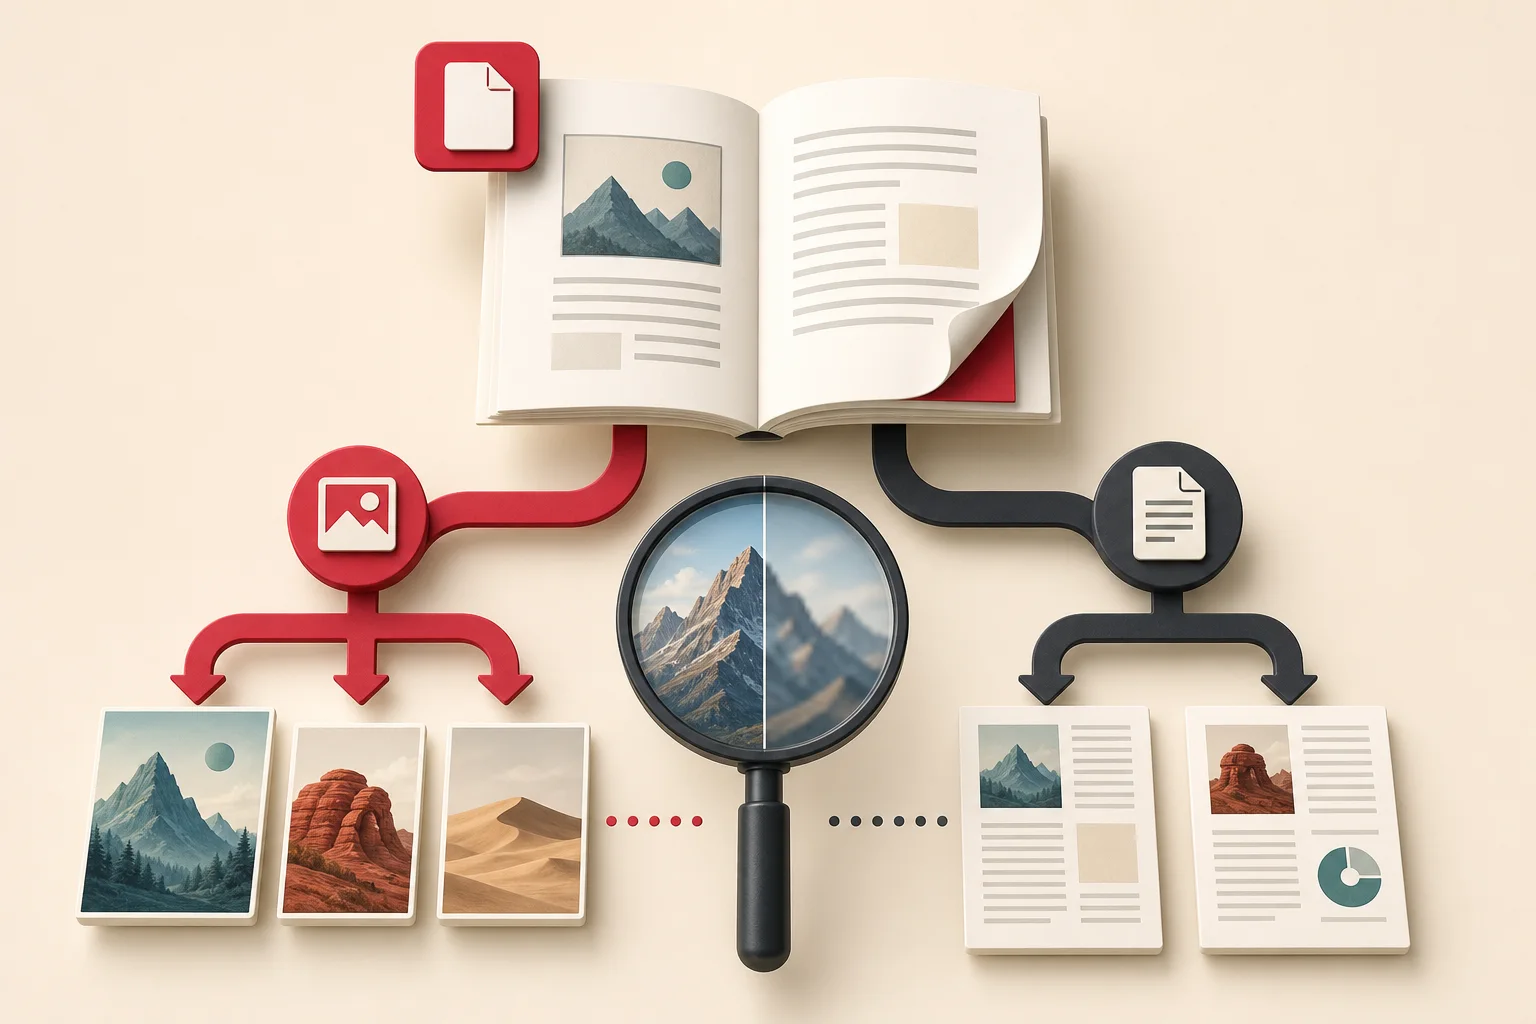
"Extraer imágenes de un PDF" puede describir dos trabajos diferentes. Un método extrae objetos de imagen almacenados dentro del archivo. El otro dibuja cada página completa y la guarda como un nuevo mapa de bits. Ambos producen imágenes, pero conservan información diferente.
La extracción integrada es útil cuando necesita fotografías originales o piezas escaneadas almacenadas en un documento. La representación de páginas es útil cuando necesita la página exactamente como la ve el lector, incluido texto, vectores, fondos, anotaciones y diseño.
Elegir el método incorrecto causa problemas familiares: pequeños fragmentos en lugar de diagramas completos, una captura de pantalla renderizada cuando querías la fotografía de la cámara, máscaras faltantes o páginas que se ven borrosas porque la resolución de renderizado era demasiado baja.
Piense en un PDF como instrucciones de dibujo
Una página PDF no es necesariamente una imagen plana. Puede combinar:
- Glifos de texto
- Caminos vectoriales
- Objetos de imagen rasterizada
- Trazados de recorte
- Máscaras de transparencia
- Degradados y patrones
- Formularios reutilizados en todas las páginas
- Anotaciones y capas opcionales
Un espectador interpreta estas piezas y pinta la página final. La extracción integrada busca ciertos objetos almacenados. El renderizado pide al espectador que pinte todo en un lienzo de píxeles.
Qué devuelve la extracción de imágenes incrustadas
Un extractor puede localizar objetos rasterizados dentro del PDF y guardar sus datos codificados o un equivalente decodificado. Una fotografía utilizada en una página puede aparecer cerca de su resolución almacenada sin texto circundante.
Esto es valioso para:
- Recuperar fotos de informes de su propiedad
- Extracción de escaneos de documentos de archivo
- Reutilizar imágenes de productos autorizados de un catálogo generado
- Inspeccionar la compresión y el espacio de color.
- Separar recursos de imagen del diseño de página
Es posible que el resultado no coincida visualmente con lo esperado. Una imagen visible se puede ensamblar a partir de varios objetos, usar una máscara separada o recortarla para darle una forma.
¿Qué devuelve la representación de la página?
El renderizado convierte una página completa en una imagen a una escala o DPI elegidos. Todo lo que el espectador pinta pasa a formar parte de un archivo rasterizado.
Esto es útil para:
- Crear miniaturas de páginas
- Preservar diagramas complejos tal como aparecen
- Compartir una vista previa de la página
- Ejecutar OCR en una página escaneada completa
- Comparando el diseño visual
- Archivar un estado renderizado exacto
El costo es que el texto y los vectores se convierten en píxeles. No puede recuperar la fotografía original por separado de la página renderizada y la calidad depende de la resolución de renderizado elegida.
Una comparación sencilla
| Pregunta | Extracción integrada | Representación de página |
|---|---|---|
| Mantiene el diseño de la página | No | si |
| Puede recuperar una fotografía solo | A menudo | No, a menos que se recorte después |
| Mantiene el texto seleccionable | No aplicable a la salida | No |
| Preserva la nitidez del vector | Solo si se extrae por separado como contenido vectorial | Rasterizado en resolución de renderizado |
| Recuento de salida | Objetos de imagen | Generalmente una imagen por página. |
| Lo mejor para | Recuperación de activos | Apariencia de la página |
Ninguno de los métodos es universalmente mejor.
Por qué una imagen visible se convierte en varios archivos
Los generadores de PDF optimizan y componen contenido de diferentes maneras. Una fotografía visible puede tener una máscara suave en escala de grises separada para mayor transparencia. Un gráfico puede contener sombreado rasterizado además de etiquetas vectoriales. Un pliego escaneado se puede dividir en tiras.
Un extractor incorporado puede devolver esas piezas individualmente. Los resultados pueden incluir:
- Imagen en color base
- máscara de transparencia
- Vista previa en miniatura
- Objeto de logotipo repetido
- Segmentos de escaneo en mosaico
- textura de fondo
Si tu objetivo es la apariencia visual, el renderizado evita el trabajo de reconstrucción. Si su objetivo es la recuperación del origen, inspeccione las dimensiones del objeto, el espacio de color, las máscaras y la ubicación antes de descartar archivos "extra".
Máscaras suaves y transparencia.
Un PDF puede almacenar los datos de color de una imagen por separado de su máscara alfa o suave. Una extracción ingenua puede producir un rectángulo sólido o una segunda imagen en escala de grises.
Una herramienta capaz puede combinarlos. Al validar la salida, compare los bordes transparentes, las sombras y las regiones difuminadas con el visor de PDF. Guárdelo en un formato que admita alfa, como PNG, WebP o un flujo de trabajo TIFF apropiado.
No convierta la transparencia a JPG a menos que agregue un fondo de manera intencional.
La ilustración vectorial no es una imagen rasterizada incrustada.
Los logotipos, diagramas e ilustraciones pueden ser rutas vectoriales. Un comando "extraer imágenes" no puede devolver nada porque no existe ningún objeto de imagen rasterizada.
Las opciones incluyen:
- Exportar el objeto vectorial a través de la aplicación de creación.
- Convertir la página o región relevante a SVG con una herramienta confiable
- Renderizado con resolución suficiente
- Recuperar el archivo fuente original del propietario del documento
Una captura de pantalla es la opción menos flexible. Es aceptable como referencia visual, pero no reemplaza a un maestro de vectores autorizado.
PDF escaneados
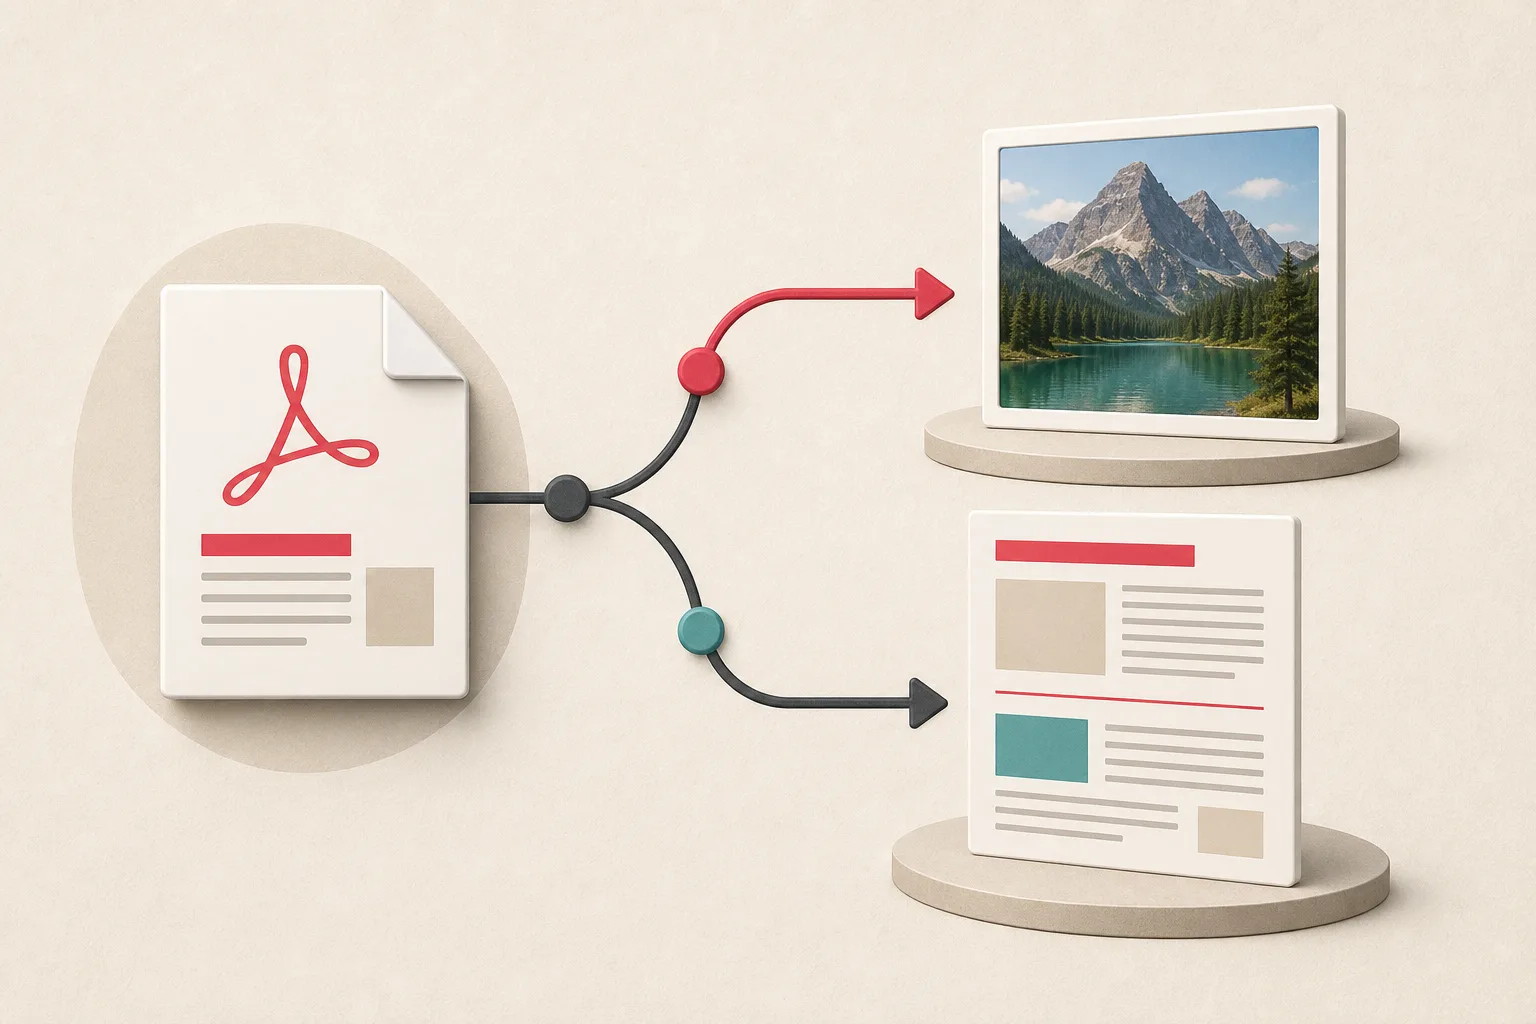
Un PDF escaneado suele contener una imagen rasterizada grande por página, a veces con una capa de texto OCR invisible. La extracción integrada puede recuperar el objeto escaneado. El renderizado crea una nueva imagen del escaneo más cualquier anotación o superposición visible.
Compara dimensiones. Si el escaneo almacenado es de 2500 por 3500 píxeles y la representación de página predeterminada es de 1275 por 1650, la extracción del escaneo incrustado conserva más detalles.
Sin embargo, un escáner u optimizador de PDF puede colocar en mosaico, reducir la resolución o recomprimir las páginas. Inspeccione los archivos representativos antes de elegir un método masivo.
Resolución de renderizado y DPI
Una página PDF tiene dimensiones físicas expresadas en puntos. La renderización a un DPI más alto crea más píxeles.
Para una página de carta estadounidense:
- 72 DPI produce aproximadamente 612 por 792 píxeles.
- 150 DPI producen aproximadamente 1275 por 1650 píxeles.
- 300 DPI producen aproximadamente 2550 por 3300 píxeles.
Un DPI más alto aumenta el tiempo de procesamiento, la memoria y el tamaño del archivo. No mejora una fotografía incrustada más allá de sus detalles almacenados. Solo proporciona al contenido vectorial y de texto más píxeles rasterizados.
Elija según el propósito. Las miniaturas de pantalla necesitan menos. Es posible que se necesite más OCR y revisión orientada a la impresión.
Resolución efectiva de una imagen incrustada
Un objeto de imagen puede ser grande pero estar ubicado en una región pequeña de la página. Su DPI efectivo depende de los píxeles almacenados y del tamaño de la pantalla física.
Si una imagen de 1.200 píxeles de ancho se coloca en cuatro pulgadas de ancho, tiene una resolución efectiva de aproximadamente 300 píxeles por pulgada. Si se estira doce pulgadas de ancho, son aproximadamente 100.
Esto explica por qué algunas fotografías en PDF parecen suaves incluso cuando las dimensiones extraídas parecen sustanciales. Es posible que el problema ya exista en el diseño del documento.
Compresión dentro de archivos PDF
Los archivos PDF pueden almacenar imágenes con varios métodos de compresión. Las fotografías suelen estar comprimidas en formato JPEG. Los escaneos monocromáticos pueden utilizar compresión especializada. Los optimizadores pueden reducir la resolución de las imágenes durante la exportación.
La extracción integrada a veces puede preservar el flujo codificado sin otra conversión con pérdidas. El renderizado siempre crea una nueva representación ráster y normalmente requiere una nueva codificación de salida.
Para una recuperación sensible a la calidad, evite renderizar una página con mucho JPEG a JPG repetidamente. Extraiga el objeto de origen cuando sea posible o renderícelo una vez en un formato sin pérdidas antes de continuar con el procesamiento.
Espacios de color
Los objetos de imagen PDF pueden usar RGB, CMYK, escala de grises, color indexado o perfiles incrustados. Un conversor rápido puede cambiar los colores o producir archivos que el software normal maneja mal.
Para documentos impresos y catálogos de productos, valide colores representativos. Conserve el PDF original y documente la configuración de conversión. No descarte una fuente CMYK simplemente porque la vista previa del navegador se ve diferente.
Recortar una página renderizada no es extracción
Recortar el renderizado de una página puede aislar la región visible de una foto, pero incluye solo los píxeles que se muestran en la resolución de renderizado seleccionada. También incorpora recortes, superposiciones y efectos de página.
Este puede ser el resultado correcto cuando la región compuesta es el artefacto que necesita. No es lo mismo que recuperar el archivo subyacente.
Un flujo de trabajo de decisiones
Haga estas preguntas:
- ¿Necesito la página completa o recursos individuales?
- ¿El objetivo es una fotografía rasterizada, un escaneo, un diagrama vectorial o una composición mixta?
- ¿Las máscaras o superposiciones afectan su apariencia?
- ¿El objeto incrustado tiene más resolución que la representación de una página práctica?
- ¿Necesito texto con capacidad de búsqueda o solo una imagen visual?
- ¿Qué color y transparencia hay que conservar?
- ¿Tengo permiso para extraer y reutilizar el material?
Luego pruebe una página representativa con ambos métodos.
Una prueba práctica de extracción
Para un PDF de su propiedad:
- Registre el recuento de páginas y el hash del archivo.
- Extraiga objetos ráster incrustados.
- Renderice las mismas páginas de muestra a un DPI documentado.
- Compare el número de resultados, las dimensiones, las máscaras, el recorte y el color.
- Identifique qué resultado coincide con el objetivo real.
- Ejecute el método elegido en el documento completo.
- Mantenga un informe de errores y excepciones.
La guía existente para extraer imágenes de un PDF cubre herramientas y flujos de trabajo cotidianos. Este artículo explica la decisión de calidad detrás de ellos.
Manejo de objetos repetidos
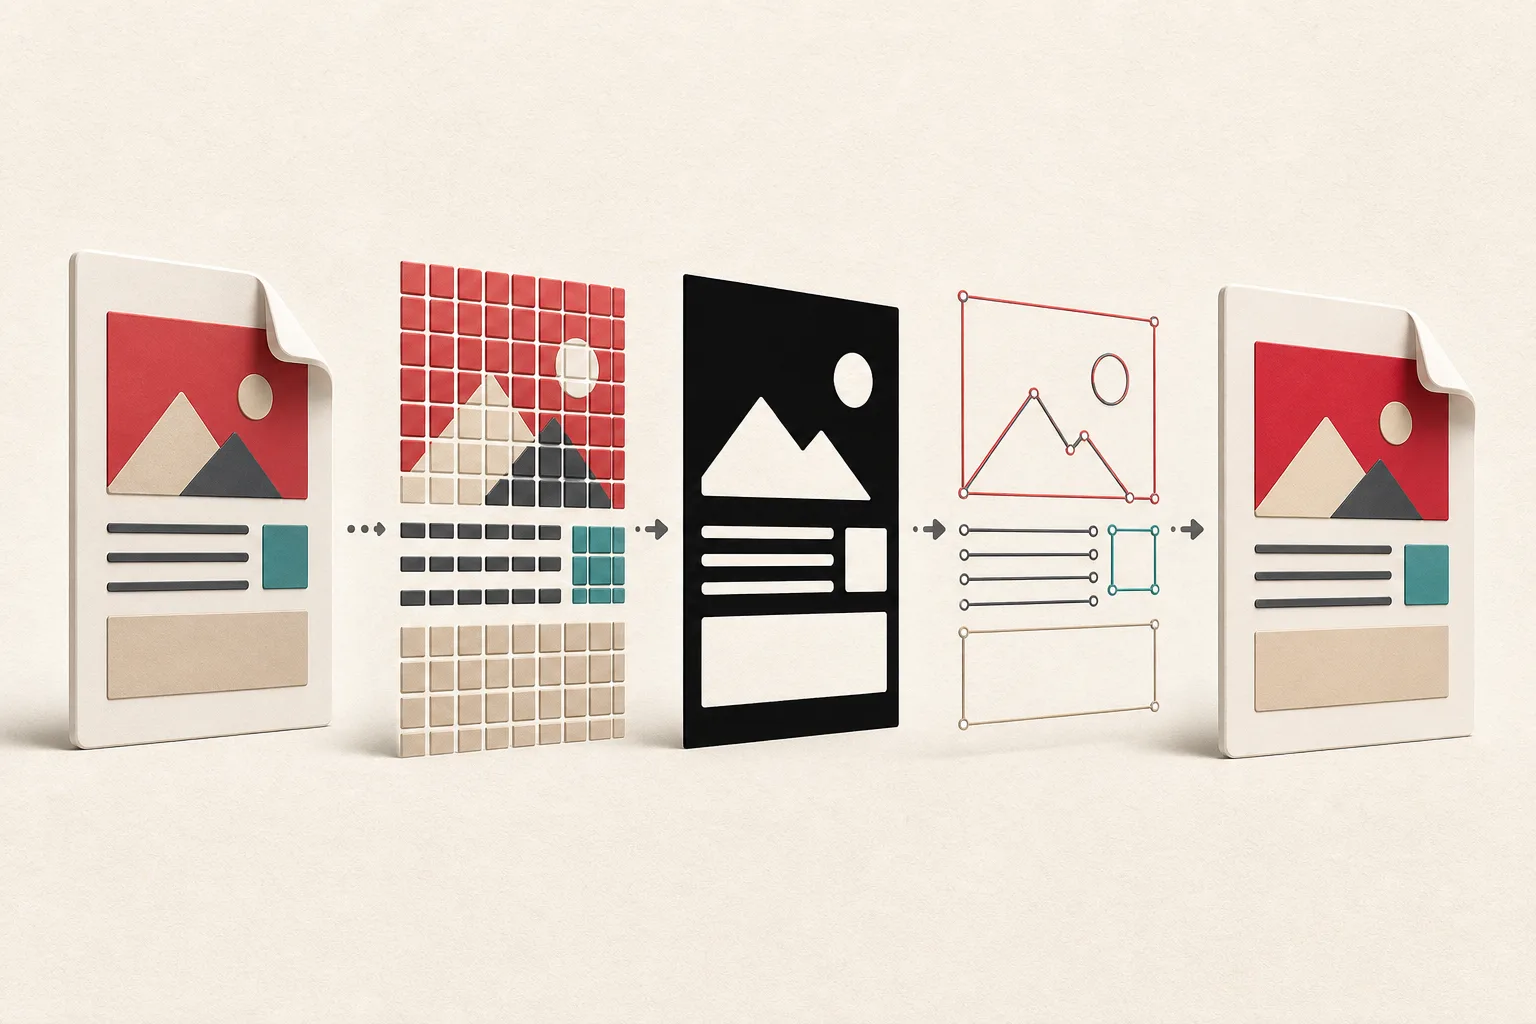
Un logotipo se puede almacenar una vez y reutilizar en docenas de páginas. Un extractor puede devolverlo una vez, mientras que un renderizador de páginas lo incluye en cada página.
Eso es lo que se espera. Para un inventario de activos, almacene un patrón con muchas apariciones de páginas. Para las miniaturas de páginas, la representación repetida es correcta.
Utilice la guía de imágenes duplicadas si una extracción grande produce resultados repetidos o visualmente similares.
Contraseñas, permisos y archivos dañados
Algunos archivos PDF están cifrados o restringen las operaciones. Utilice la contraseña del documento y el flujo de trabajo permitido proporcionado por el propietario. No intente eludir los controles.
Las tablas de referencias cruzadas dañadas u objetos con formato incorrecto pueden provocar una extracción parcial. Un espectador puede recuperarse lo suficiente como para mostrar la página mientras falla un extractor. Mantenga el error, pruebe un flujo de trabajo de reparación confiable en una copia y compare recuentos de páginas y sumas de verificación.
Nunca sobrescriba el único PDF durante la reparación.
Metadatos y contenido sensible
Las imágenes extraídas pueden revelar información que no es obvia en una vista de página normal, incluidas regiones sin recortar, capas ocultas, firmas, caras o metadatos. Trate la recuperación de documentos como potencialmente confidencial.
Almacene los resultados de forma segura y revíselos antes de su publicación. Elimine los metadatos privados únicamente mediante un flujo de trabajo de copia documentado, preservando al mismo tiempo el archivo original.
Nomenclatura de archivos y manifiestos
La producción masiva se vuelve confusa rápidamente. Tienda:
- Nombre de archivo PDF y hash
- Número de página
- Número de objeto cuando esté disponible
- Método de extracción o renderizado.
- Dimensiones y formato de salida
- Relación de máscara
- Estado de revisión
No nombre cada salida image1.jpg. Un manifiesto hace posible las excepciones y la reconstrucción.
Controles de calidad
Inspeccionar:
- Texto fino y etiquetas.
- Bordes transparentes
- Degradados
- Textura de piel y tela.
- Consistencia del color
- Azulejos faltantes
- Páginas rotadas
- Límites de cultivos
- Corrupción de archivos
Compare las páginas primera, intermedia y final, además de ejemplos complejos conocidos. No juzgues una tirada de 500 páginas sólo desde la primera página.
Interconexión con otros flujos de trabajo de archivos
Los archivos de PowerPoint y Word también almacenan medios por separado de la apariencia de la página o del documento renderizado. La guía de extracción de imágenes de PowerPoint y la guía de extracción de imágenes de Word existente utilizan una idea relacionada de recuperación de paquetes.
Los formatos difieren, pero se aplica la misma pregunta: ¿necesita recursos incrustados originales o una representación visual aplanada?
Derechos de autor y autorización
Ser propietario de un archivo PDF no otorga automáticamente derechos para volver a publicar cada fotografía que contiene. Los informes pueden contener acciones con licencia, material de clientes, gráficos de otros editores y datos personales.
Extraiga los archivos que posee o que está autorizado a recuperar. Preservar créditos y registros de licencias. Para imágenes inciertas, utilice la lista de verificación de fuentes y licencias.
Elija la salida que coincida con el trabajo
La extracción integrada y la representación de páginas responden a diferentes preguntas. Uno pregunta: "¿Qué objetos rasterizados se almacenan aquí?" El otro pregunta: "¿Cómo debería verse esta página cuando se dibuje?"
Pruebe ambos en una página que contenga una fotografía, texto y un elemento vectorial. La diferencia se hace evidente rápidamente. Utilice los archivos objeto para la recuperación del código fuente y una representación de página deliberada para una apariencia fiel. Mantenga el PDF intacto y registre el método, el número de página y la configuración; de lo contrario, resulta imposible explicar una carpeta de resultados numerados más adelante.